| カンマ区切り |
csvパッケージは、CSV(カンマ区切り)のテキストファイルを解析し、 各フィールドをTclリストに格納したり、Tclリストからcsvの行を作ったりする、 あると便利な小物ルーチンです。使い方も簡単で、
package require csv
set a {ABCD 日本語 {def,fg} 9876 "This is a pen."}
set b [::csv::join $a]
puts $b
# 出力: ABCD,日本語,"def,fg",9876,This is a pen.

set c {This is a pen,9876,"def,fg",日本語,ABCD}
set d [::csv::split $c]
puts $d
# 出力: {This is a pen} 9876 def,fg 日本語 ABCD
|
こんな感じです。
| URIトークンの切り出し |
URI(Uniformed Resource Identifier)とは、ぶっちゃければURL(Uniformed Resource Locator) とほとんど同じものと解釈すればとりあえずよいでしょう。uriパッケージは、このURI、例えば
http://www.nsnhnkmmkk.co.jp:8000/data/log.dat?opt=111このような書式を、プロトコル(scheme)、ホスト名、ポート番号、 ディレクトリパス、その他に分割し、Tclリストにして返すものです。 uri::geturlコマンドを使えば、プロトコル(scheme) の部分がhttp、ftpなどである場合、実際にそれらのプロトコルを使って URIが指すコンテンツを受信してくることができます。 受信データは、例えばHTTPの場合は http::data コマンドで取得できます。
package require uri
set baseurl "http://www.nsnhnkmmkk.co.jp/"

while 1 {
    puts -nonewline "> "; flush stdout; set u [gets stdin]
    if {"$u" == ""} break

    # http://www.nsnhnkmmkk.co.jp:8000/data/log.dat
    puts "split: [::uri::split $u]"
    # port 8000 path data/log.dat scheme http
    #   host www.nsnhnkmmkk.co.jp query {}
    if [::uri::isrelative $u] {
        puts "Specified URI \"$u\" is relative:"
        puts "Resolved: [::uri::resolve $baseurl $u]"
    }
    set token [::uri::geturl $u]
    puts "******"
    puts [::http::data $token]
    puts "******"
}
|
| ディレクトリパスの再帰検索 |
ディレクトリを再帰的に下降しながらファイルを探したり、 エントリ数をカウントしたり、おやつを食べたりするコマンドはC言語拡張のTclXでも提供されていますが、 こちらはTcl版であります。 このようなルーチンはきっと世界中のTclプログラマがお手製のライブラリとして一度は作ったと思うのですが、 ここにTcl Developer Exchange特製の標準バージョンが登場したわけです。
まず、簡単なファイルグロブ(aka. 「パターンマッチ」) やファイル名の正規表現でファイルを探すコマンドがfileutil::findByPatternです。 使いかたは簡単で、UNIXのfindコマンドと同様、探索の起点となるディレクトリと、 その探したいパターンを指定するだけで、該当するファイルのフルパスのリストが返ってきます。
package require fileutil
set basedir /temp
set result [::fileutil::findByPattern $basedir -glob t*.tcl]
foreach e $result { puts "\[$e\]" }
|
findByPatternはこのように、該当するファイルの一覧を絶対パスのリストで返してきます。 絶対パスの中にカレントディレクトリ(つまりpwdが返す値)が含まれている場合これを削って、 カレントディレクトリからの相対パスにして返すには、 同じパッケージのfileutil::stripPwdコマンドが使えます。
package require fileutil
set basedir /temp
set files1 [::fileutil::findByPattern $basedir -glob t*.tcl]
set files2 {}
foreach e $files1 { lappend files2 [::fileutil::stripPwd $e] }
puts $files2
|
また、もう少し発展させて、各ファイルの編集日時とサイズを表示する、 簡単なツールを作ってみます。 ファイル探索の起点となるディレクトリはコマンドラインで指定します。
package require fileutil

if {[set basedir [lindex $argv 0]] eq ""} {
    puts stderr "usage: $argv0 dirName"; exit 1
}

foreach path [::fileutil::findByPattern $basedir -glob *] {
    set mtime [clock format [file mtime $path] -format "%Y/%m/%d %H:%M"]
    set sz [file size $path]
    puts [format "%-15s %10d %s" $mtime $sz $path]
}
|
はてさて、単純なパターンマッチではなく、もっと複雑な検索条件をかけたい場合、つまり、 「フィルタをかける」ことをしてみたい場合、 もっと低位の fileutil::findが使えます。 このコマンドは起点ディレクトリと「フィルター」を定義したコマンドを指定します。 このコマンドはファイル名(ディレクトリパスは含まれないので注意!) を引数として渡されるので、該当させたい場合は1を、そうでなければ0を返すように組めばOKです。
package require fileutil
set basedir .
# この引数のfilenameにはディレクトリパスは含まれないので注意
proc filtercmd filename {
    if {[regexp ic $filename]} {return 1} {return 0}
}
# resultには、ファイル名に ic を含むファイルのパスのリストが入る
set result [::fileutil::find $basedir filtercmd]
foreach e $result { puts "\[$e\]" }
|
なお、findコマンドの引数は両方とも省略できます。 起点ディレクトリを省略すると、.つまりカレントディレクトリが起点となります。
また、フィルターとなるコマンドを省略すると、 出会う全てのファイルが該当するとみなされます。 その場合、ディレクトリもファイルも関係なく該当する点には注意が必要です。 ファイルだけをリストにしたい場合は、 結局フィルターprocを定義してディレクトリを除外するか、 findByPatternを使うことになるでしょう。
おまけでもう4つ、 このfileutilパッケージに含まれるコマンドを紹介します。 ありゃ、パッケージ名の紹介が遅くなってしまいました。 パッケージ名は「fileutil」です!(遅いって)
package require fileutil

set filename [lindex $argv 0]
set buf [::fileutil::cat $filename]
puts $buf
# bufを何か加工する
::fileutil::writeFile "${filename}.new" $buf
|
逆に、Tcl世界で持っている文字列の内容を一度にファイルに出力する、 fileutil::writeFileコマンドもあります。 これにも-translation、-encodingなど、fconfigureコマンドと同様のオプションが指定できます。 これら2つのコマンドを使うと、 ファイルの一括読み書き処理がとても簡潔に記述できます。
また、fileutil::catはファイル全体を一度に読むコマンドでしたが、 テキストファイルを1行読むたびに何かしたいというときには、 fileutil::foreachLineがよろしゅうございます。
このコマンドは、典型的には次のように使います。
package require fileutil

proc rproc buf {
    # 1行読むたびに行う処理
}

::fileutil::foreachLine buf "C:/the/path/of/infile.txt" {rproc $buf}
|
1. 変数bufに格納する。
2. 最後の引数のコマンド(上の例では
rproc $buf)を実行する。の手順を繰り返す、という処理になります。
もう1つ、fileutil::grepというコマンドもあります。 こちらもUNIXのgrepコマンドと同じく、 テキストファイルの中から指定した正規表現を含む行を検索して返すコマンドです。 下の例は、ディレクトリを再帰的に降りながら、 "*.tcl" というファイルを探し、その中で「require」 という行を含むものを表示するスクリプトです。 このようなツールを実験室では従来ライブラリアンと呼びならわして、 さまざまな言語で作ってきたのですが、 今まで作った中で下のルーチンが一番簡単です。これは楽ちんさんです。 いやいや、いろんなことが複雑になってしまった世の中、 たまには楽な時代になったと言わしてくださいな。
package require fileutil
set basedir .

foreach file [::fileutil::findByPattern $basedir -glob "*.tcl"] {
    foreach e [::fileutil::grep "require" $file] {
        # 各要素は検出したファイル名、行番号、行の内容を:
        # で連結した文字列になっています
        puts $e
    }
}
|
それでこの、ファイル名、行番号、行の内容をコロンで連結した文字列を返すのが結構曲者です。 Windows環境ではファイル名の中にドライブを表すコロンが含まれます (言い忘れましたが、このファイル名は、 開始ディレクトリからの相対パスではなく、ファイルシステム上の絶対パスです) ので、単純にsplitコマンドで切ることはできず、下のようにregexpで分割することになります。
set r [regexp {^(.+)\:(\d+)\:(.*)$} [lindex $e 0] all filename lineno content]
if $r {
    set content [lindex $content 0]
    $f.txaa insert end "$filename\t$lineno\t$content\n"
}
|
少しだけ実用的な例ということで、findByPatternとgrepを両方使った例をご紹介します。 起点ディレクトリから再帰的にファイルを辿りつつ、指定した文字列を含むファイルを見つけたら表示します。 この例では日本語の文字列でも指定でき(Windows環境なら)SJIS(cp932)とUTF-8のどちらで書かれたファイルも検索できます。
package require fileutil

set BASEDIR "C:/work/repo/sec"
set TARGET_STRING "ダウンロード"

# fileutil::grepのencodingが指定できる版です。オリジナルのfileutil.tclを参考に
proc grep_with_encoding {pattern files encoding} {
    set result [list]
    foreach filename $files {
        set file [open $filename r]
        # ↓この行を追加しただけ
        fconfigure $file -encoding $encoding
        set lnum 0
        while {[gets $file line] >= 0} {
            incr lnum
            if {[regexp -- $pattern $line]} {
                lappend result "${filename}:${lnum}:${line}"
            }
        }
        close $file
    }
    return $result
}

foreach file [::fileutil::findByPattern $BASEDIR -glob "*.*"] {
    # ディレクトリはgrepできないので読み飛ばす
    if {[file isdirectory $file]} { continue }

    set rlist [::fileutil::grep $TARGET_STRING [list $file]]
    # ↑ファイル名に空白を含む場合に備えてlistで囲んでいます。

    # 1ファイルに複数行が該当した場合、
    # 結果はそれらのリストになっているので、分解して1行ずつ表示
    if {[llength $rlist] > 0} { foreach e $rlist { puts "S|$e" } }

    # fileutil::grepはopenでファイルを普通に読むので、
    # 文字コードはSystemDefault(日本語版Windowsだとcp932)で読もうとする。
    # 検索文字列が日本語を含んでいる場合はUTF-8の場合も考慮して判定する
    if {[llength $rlist] == 0 && [regexp {[\u0080-\uffff]} $TARGET_STRING]} {
        # 上記で該当行がなく、検索文字列が非ASCII文字を含んでいる場合
        set rlist [grep_with_encoding $TARGET_STRING [list $file] utf-8]
        if {[llength $rlist] > 0} { foreach e $rlist { puts "U|$e" } }
    }
}
|
| オプションの解析 |
Tclスクリプトを便利なツールとして組んだとき、 コマンドライン・オプションも工夫を施したいものです。 これまでは各スクリプトの中で変数argvの各要素を調べてオプションをチェックする処理を書く必要がありましたが、 このcmdlineパッケージを使うと、 とても簡単にオプションの解析を行うことができます。
package require cmdline

while 1 {
    puts -nonewline ">"; flush stdout
    set cmd [gets stdin]
    if {"$cmd" == ""} break
    # .arg をつけると、オプションの値をとることを指示します。
    # この場合オプションをつけないと-1が返ります。
    puts [::cmdline::getopt cmd {c d f.arg V} optvar valvar]
    puts "option: $optvar value: $valvar"
    # -f tmp.dat とすると、戻り値1 optvar = f valvar = tmp.dat
    # -f         とすると、戻り値-1
    # -d         とすると、戻り値1 optvar = d valvar = 1
    # -d 20      としても、戻り値1 optvar = d valvar = 1
    # tmp.dat    とすると、戻り値0 optvar =   valvar =
    # -- -f tmp.dat とすると、戻り値0 optvar =   valvar =
}
|
cmdline::getoptコマンドがそのオプション解析を行うコマンドです。 最初の引数がコマンドラインの文字列を格納している変数の名前、 次の引数がこのスクリプトが受け入れることのできるオプションのリストです。 ここでは {c d f.arg V} となっていますのが、 これは -c -d -f -V の4種類のオプションがとれるということです。 .argをつけると、そのオプションに対応する値も指定する必要があることを指示します。 この場合、f.arg としているので、 「-f filename」のように、後続の引数で対応する値を指定しないといけません。 最後の2つの引数(例の中のoptvarとvalvar)はオプションで、 変数の名前を指定すると、解析結果が格納されます (格納例は例の中のコメントをご覧下さい)。
戻り値ですが、第1引数のコマンドラインの中に、 第2引数で指定したうちのどれかのオプションがあった場合には1が、なかった場合には0または-1が返ります。
| CGIユーティリティ |
共通ゲートウェイ・インターフェース(CGI)は、 トランザクションの少ない個人または小規模のWebサイトにおいて、 ユーザのリクエストに応じてWebサーバー側で何か処理をしたり、 動的なWebコンテンツを返信したり、おやつを食べたりするための Webサーバー内部の仕組みで、その記述言語には従来PerlやCがよく使われてきました。 が、当然、TclやPythonなど他の汎用スクリプト言語で書くことも可能で、 また、パーソナルユースでスクリプト言語を操る人々の間では、 CGIスクリプトを書くということが、 こうした汎用スクリプト言語の「実用性」をはかるひとつの目安となってきたフシもあります。 そのため、汎用スクリプト言語の多くには、 CGIを簡単に書くためのライブラリが本体または本体に近いオプションパッケージとして配布されています。 Tcl言語でCGIを書くためのライブラリは何種類も公開されていますが、 このncgiパッケージが tcllib で採用されたことにより、事実上標準への道を歩むことになるのでしょう。 ncgiはシンプルですが一通りのCGI機能を実装してあるので、 これを使えばCGIの内部処理を細かく書き込まなくてもよくなり、 これまた開発の生産性を上げてくれるライブラリがようやく現れたといえるでしょう。
まずは、簡単なHTMLフォームのページです。
<html> <body bgcolor="white"> <form action="/cgi-bin/tcllib/test.cgi" method="put"> あなたの名前 <input type="text" size=20 maxlen=14 name="username"> メールアドレス <input type="text" size=20 maxlen=14 name="mailaddress"><br> <input type="submit" value="OK"> <input type="reset" value="Reset"><br> </form></body></html> |
これに対応するCGIスクリプトです。
#! /usr/local/bin/tclsh
package require ncgi

proc putsHeader {} {
    ncgi::header "text/html;charset=EUC_JP"
    puts {
        <html><head><title>CGIの処理結果</title></head>
        <body bgcolor="white">
    }
}

proc putsFooter {} {
    puts {</body></html>}
}

# 戻り値はいわゆる QUERY_STRING です。
set r [ncgi::query]
# CGI変数のリストを返します。
set r [ncgi::parse]

if {[ncgi::empty "username"]} {
    putsHeader
    puts {<h2>おおっと</h2>名前を入力して下さい。}
    putsFooter
    exit
}

# ここで、CGI変数の値は空白→+などのエンコードがかけられているのを
# 変換します。
set userName [ncgi::decode [ncgi::value "username"]]
set mailAddress [ncgi::value "mailaddress" "unknown@a.com"]

set cookieName "customer"
ncgi::setCookie -name $cookieName -value $userName
set cookieName "mailaddr"
ncgi::setCookie -name $cookieName -value $mailAddress

putsHeader
puts "<h2>ようこそ</h2> ${userName}さん($mailAddress)、こんにちは。<br>"
puts "インターネット店舗は<a href=\"/cgi-bin/tcllib/test2.cgi\">こちら</a>"
puts "です。<br>"
putsFooter
# end.
|
- まず、この例のように、ユーザから入力フォームでパラメータを受け取る場合、 ncgi::queryと ncgi::parseを使って、 パラメータをCGI変数に格納します。
- 格納したCGI変数は、 ncgi::valueと ncgi::decodeを使って参照できます。 ncgi::decode は、 パラメータの文字列は空白文字が「+」になるなどのエンコードが行われているので、 これを元の文字列に復元する処理を行うものです。
- ncgi::headerを使い、 HTTPヘッダを送信します。
- HTML文書の本体をputsコマンドで標準出力に書き出します。
set cookieName "customer" ncgi::setCookie -name $cookieName -value $userName set cookieName "mailaddr" ncgi::setCookie -name $cookieName -value $mailAddressこのように、ncgi::setCookieを使うことで、 ブラウザに「この名前、この値のクッキーをセットせよ」 という指令を、HTTPヘッダに付加することができます。 これが暗に意味することは、ncgi::setCookie は ncgi::headerより先に実行しなくてはいけないということです。 では、クッキーがブラウザにセットされたところで、 上の「インターネット店舗」なるリンクを伝っていきましょうか。 リンク先はこのようなCGIのページです。
#! /usr/local/bin/tclsh
package require ncgi
ncgi::header

set customer [lindex [ncgi::cookie "customer"] 0]
set mailmail [ncgi::cookie "mailaddr"]

puts "<html><body bgcolor=\"white\">"
if {"$customer" == ""} {
    puts {
<h2>ブラウザにクッキーが設定されていません。</h2>
<a href="/index.html">ホームページに戻る</a>
    }
} else {
    puts "<h2>${customer}さんには開運の壷がお勧めです。</h2>"
    puts "今なら特別価格なので、さっそく
 ${mailmail} に資料をお送りします。<br>"
    puts "またのお越しをお待ちしています。<br>"
}
puts "</body></html>"
# end.
|
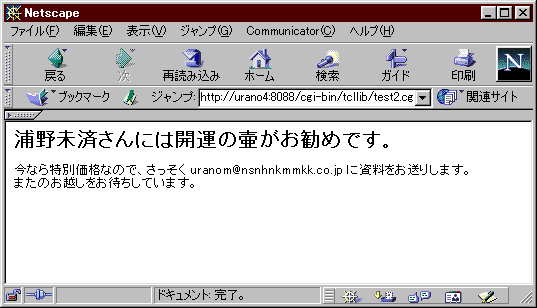
ちょっと待て
クッキーの値を取り出すのも簡単で、 ncgi::cookieでクッキーの名前を指定するだけです。
と・いうわけで、ncgiパッケージにはCGIスクリプトを書くための仕組みが一通り揃っているのが確認できました。 CGIなら直書きでも書けるわい、という向きもあるかと思いますが、 このようなライブラリが公開されること自体は、 世界中のプログラマに散らばった便利なコードの統合を図ることで、 言語の標準化という意味で意義深いと言えるのではないでしょうか。 いや、それこそが、「Standard」Tcl Library たるtcllibのむしろ真の存在意義と言うべきなのでしょうか。
●ログのアクセスURLをデコードする
最後にCGI以外のncgiの用途を一つおまけで。
このサイトは違いますが、プロバイダから無料で提供されているWikiやブログには、
アクセス履歴を見る機能がついています。
サイトを見て頂いた方が、どんな検索語で検索エンジンから来てくれたのかを見るのは楽しいものですね。
そのとき検索語はURLにエンコードされているので、日本語を確認するためには変換が必要です。
そこで作ったのが下のツール。URLをコピーペーストして「変換」ボタンを押すと、
デコードした文字列が表示されます。
package require ncgi

entry .txtURL -width 60
label .labNewURL
set f [frame .fcmd -rel groove -padx 2 -pady 2]
button $f.cmda -text "変換" -command "tform .txtURL .labNewURL"
button $f.cmdc -text "クリア" -command ".txtURL delete 0 end"
button $f.cmde -text "終了" -command exit
pack {*}[winfo children $f] -side left -padx 2 -pady 2
pack {*}[winfo children .]  -side top

proc tform {wurl lnew} {
    set url [$wurl get]
    set newURL [::ncgi::decode $url]
    $lnew configure -text $newURL
}
|
(first uploaded 2001/10/27 last updated 2023/08/30, MISUMI URANO - KOUKEN HEIJIMA)